LH85 - La LH de la lecture
C'est une nouvelle semaine qui démarre. Le matin, après avoir discuté avec (la moitié de) l'équipe (les autres sont en vacances), j'ai continué avec le rangement des archives. Cette fois, je m'attaque aux ND de 2022 (les archives des ND vont de 2016 à 2025), qui sont ma foi assez fournies. Comme vendredi, des dossiers fantômes sont réapparues pour certaines ND de 2024 et 2023, dont certains ayant une date de modification antérieure à leur date de création (SharePoint goes brrr). Et même après des heures à coder et à restructurer des ND, j'ai encore été surpris : une ND peut en cacher une autre ! En exécutant mon script pour les ND du RER A, l'une des ND m'a retourné un paquet d'erreurs de "fichier déjà existant" (parce que dans l'une des ND, il en y avait deux autres). Et heureusement que j'ai réussi à faire une sauvegarde du dossier original avant que la synchronisation ne soit effectuée, car sinon il m'aurait été très compliqué de discerner les ND entre elles.
Après ce petit incident sans grandes conséquences, j'ai démarré le tri des ND de la ligne B avant d'aller manger à la cantine (il y en a 60...). A mon retour, j'ai (enfin) échangé avec Nathalie (la n+1 de Blandine) : elle vérifie tous les documents qui entrent et sortent de l'USFR (chaque document qui sort est conforme aux exigences voulues). Elle peut aussi venir en appui de l'équipe si la charge de travail est trop importante (par exemple, pendant certaines vacances scolaires).
Une différence notable entre la RATP et la SNCF concerne les évolutions (modifications de la réglementation, par exemple à la suite d'un incident sur la ligne) : la SNCF les publie en juin et en décembre (ce qui peut poser des problèmes de temps en cas de prévention tardive), alors que la RATP les publie un peu pendant toute l'année.
J'ai terminé ma journée en finissant les ND de la ligne B, puis en traitant les ND des deux lignes.
Après trois jours passés à Lagny, je me dirige aujourd'hui vers la Gare de Lyon, pour y retrouver Pascal, qui fait partie d'une équipe informatique de gestion des sites et logiciels. En l'occurence, son équipe est chargée du frontend (interface utilisateur et support) de Guépard (Base de données), Gecco (service de mails), du portail vers les archives papiers, de Adobe Sign et d'un gestionnaire de workflow dont j'ai oublié le nom.
A 9 heures (le train de Pascal a été supprimé, donc il a du attendre un peu), nous sommes rentrés à la Maison de la RATP, puis j'ai laissé ma carte d'identité à l'accueil contre un badge visiteur (seul moyen pour moi d'entrer, étant donné que je n'ai pas de badge). Après un trajet en ascenseur (ils en ont qui sont très rapides et capacitaires), Pascal m'a présenté quelques membres de son équipe. En tout, ils sont 6 : 4 salariés, 1 alternant et 1 CDD conjoint avec une autre équipe (au moment de mon immersion, ils étaient 3 salariés et l'alternant).
In a nutshell, ils s'occupent des clients qui font des tickets (il y a un outil spécifique pour les tickets : Gedem, qui permet de garder une trace de chaque ticket ouvert ou fermé), de tester des nouveautés avant de les déployer en prod (ils ont 2 serveurs : le serveur "production" (ou "prod") qui est celui accessible par les clients comme Blandine, et le serveur "recette", privé et fait pour les tests avant la mise en prod), de corriger d'éventuels bugs... En ce qui concerne Guépard, les requêtes sont traitées en SQL, et j'ai pu voir un fragment du code les traitant (évidemment, les clients n'écrivent pas directement des scripts SQL (dommage), ils passent par un moteur de recherche...). Notons également que les serveurs où sont hébergés tous ces services ne sont pas à Paris, mais à Bailleul.
Chaque jour, Pascal ouvre sa boîte mail et consulte une version écourtée des logs de Guépard (les logs sont un fichier répertoriant chaque action faite sur le site avec leurs dates. Ces fichiers peuvent assez facilement faire quelques dizaines de milliers de lignes). Par exemple, la veille, deux des services de l'application ont été interrompus (RER B intensifies) pendant une trentaine de minutes. C'est alors à l'équipe de résoudre le problème (et, si besoin, de contacter l'équipe responsable du backend - tout ce que l'utilisateur ne voit pas et qui fait tourner un site ou une application - pour traiter le problème).
En parlant de backend, il y a eu deux réunions pendant la matinée : la première concernait toute l'équipe et était une réunion récurrente pour faire le point sur les avancées, les problèmes, le futur proche... Ensuite, une deuxième réunion avec une personne de l'équipe backend (qui, au passage, fait partie de la branche MOE, pour Maîtrise d'OuvragE) a consisté en discussions sur la cybersécurité (notamment, un fichier JSON (qui stocke des données de toute nature) était accessible pour les clients alors qu'il ne devrait pas l'être), sur le RGPD, ou encore sur la manière d'afficher les données sur le site. Un autre problème discuté était le fait que Guépard était très très lent à traiter une requête. Cela est dû à un oubli (ou à une mauvaise manip') qui faisait que le site était en mode "full", et non pas en mode "delta" (après basculement, la requête s'exécutait en moins d'une minute). Un dernier bug évoqué est celui d'une redirection vers une page normalement interdite d'accès aux personnes extérieures au frontend et au backend (après investigation, il a été remarqué que cela se produisait pour les utilisateurs ayant un compte sur Guépard mais pas de compte sur un autre service connexe (OTDS)).
La réunion s'est terminée à 12 heures 20, et nous sommes donc allés manger à la cantine, qui s'apparente plus à un restaurant (on commande sur une application, puis un personnel vient nous amener le plateau avec la commande).
Après le repas (qui était plutôt très bon par ailleurs), nous sommes retournés aux bureaux. Mais le PC de Pascal a mis une éternité avant de fonctionner correctement (il a mis au moins 10 minutes à juste redémarrer, puis le cable Internet + chargeur + écran multiples faisait des faux contacts, ce qui ralentissait grandement le système) (mais il a quand même fini par fonctionner à peu près normalement). Pascal a tout de suite vu que quelqu'un lui a signalé un problème supposément interne (pas la faute d'un client, et pas un client qui a fait une fausse manip') à Guépard : le nom d'un document ne correspondait pas avec son contenu (et donc cela pose problème pour la recherche SQL).
Avant de quitter les locaux, j'ai assisté à une troisième réunion : il s'agit de la suite de la deuxième réunion, par rapport à Gecco (le service de mail) (plus précisément, ils veulent changer de service pour plusieurs raisons). Ils ont discuté de la procédure à suivre (qui est un peu chaotique mine de rien) pour obtenir les fonds nécessaires (qui se résume très grossièrement en : Compréhension, Préparation et Etude).
Ils ont également galéré à trouver des templates (documents vierges à compléter, qui sont déjà structurés correctement) pour la procédure. Et, comme par hasard, ils ont galéré à les trouver sur... SharePoint (et oui, encore lui !).
Pour finir, voici quelques photos prises (avec autorisation) dans les locaux :
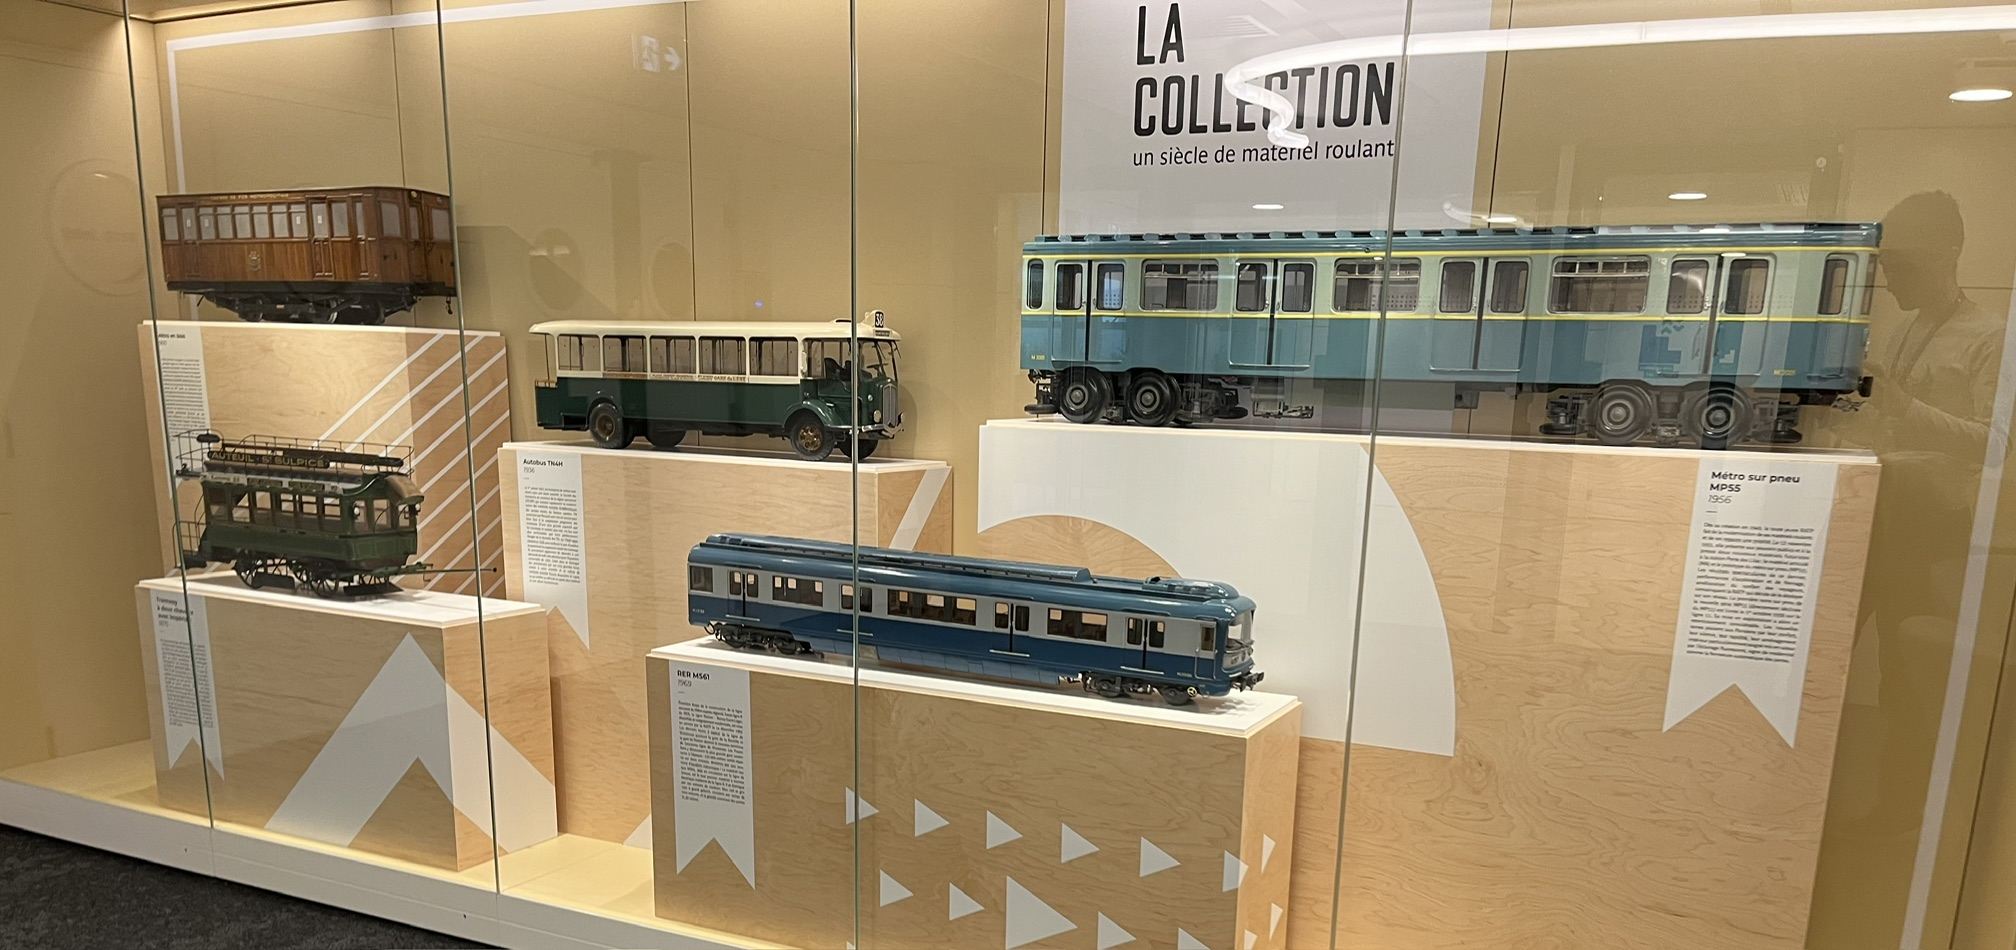
Exemples de vieux matériel roulant sous forme de maquettes
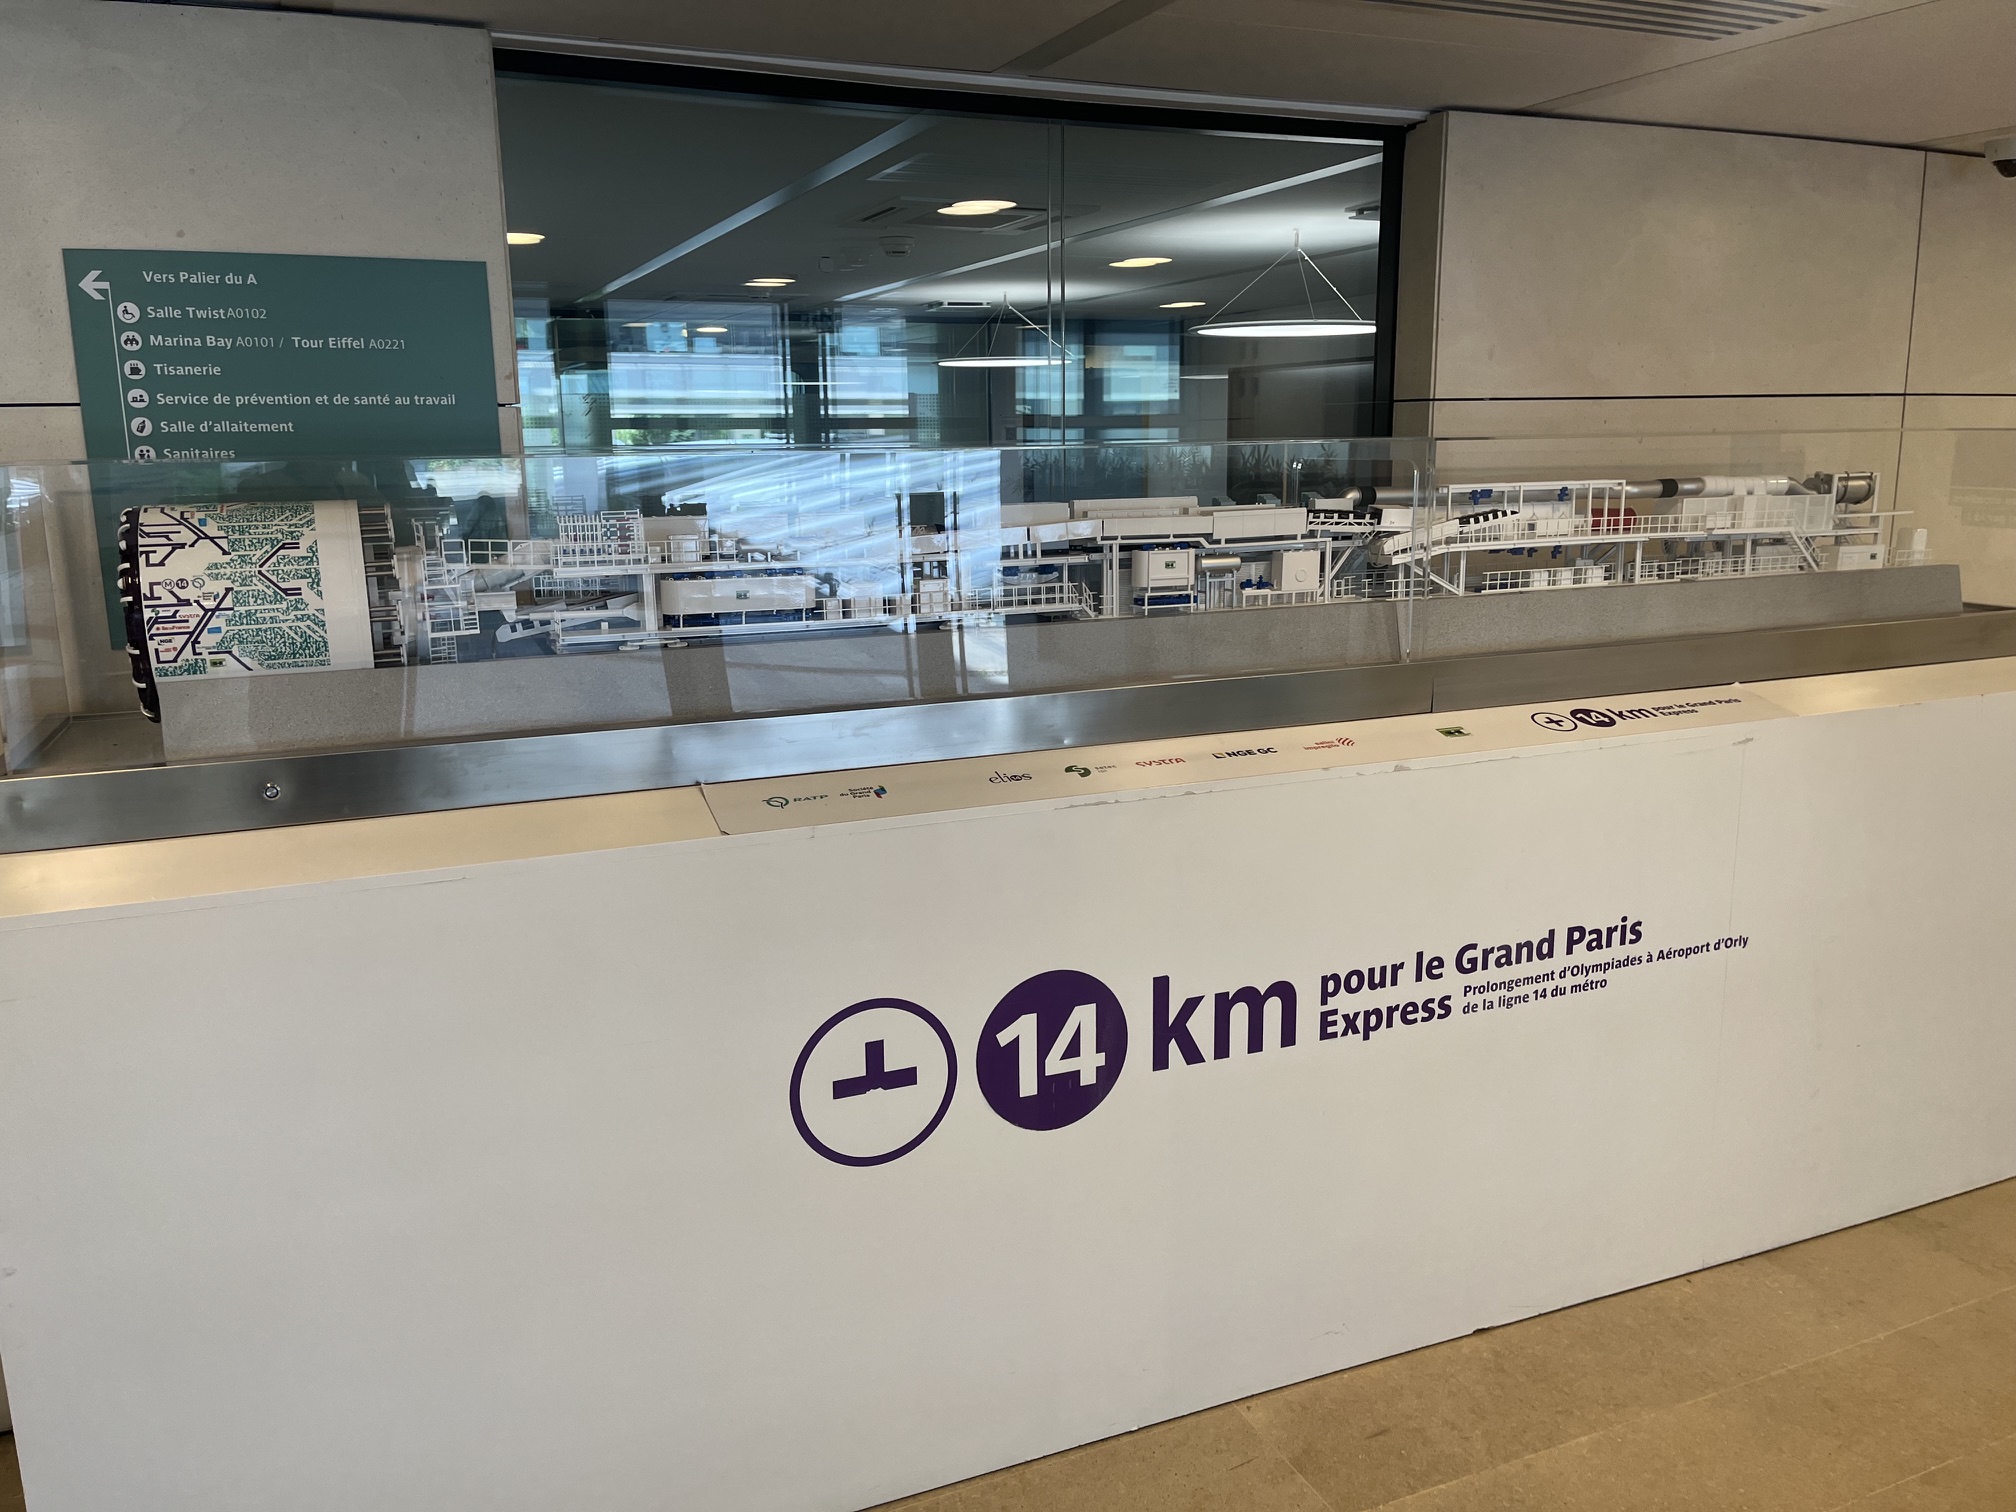
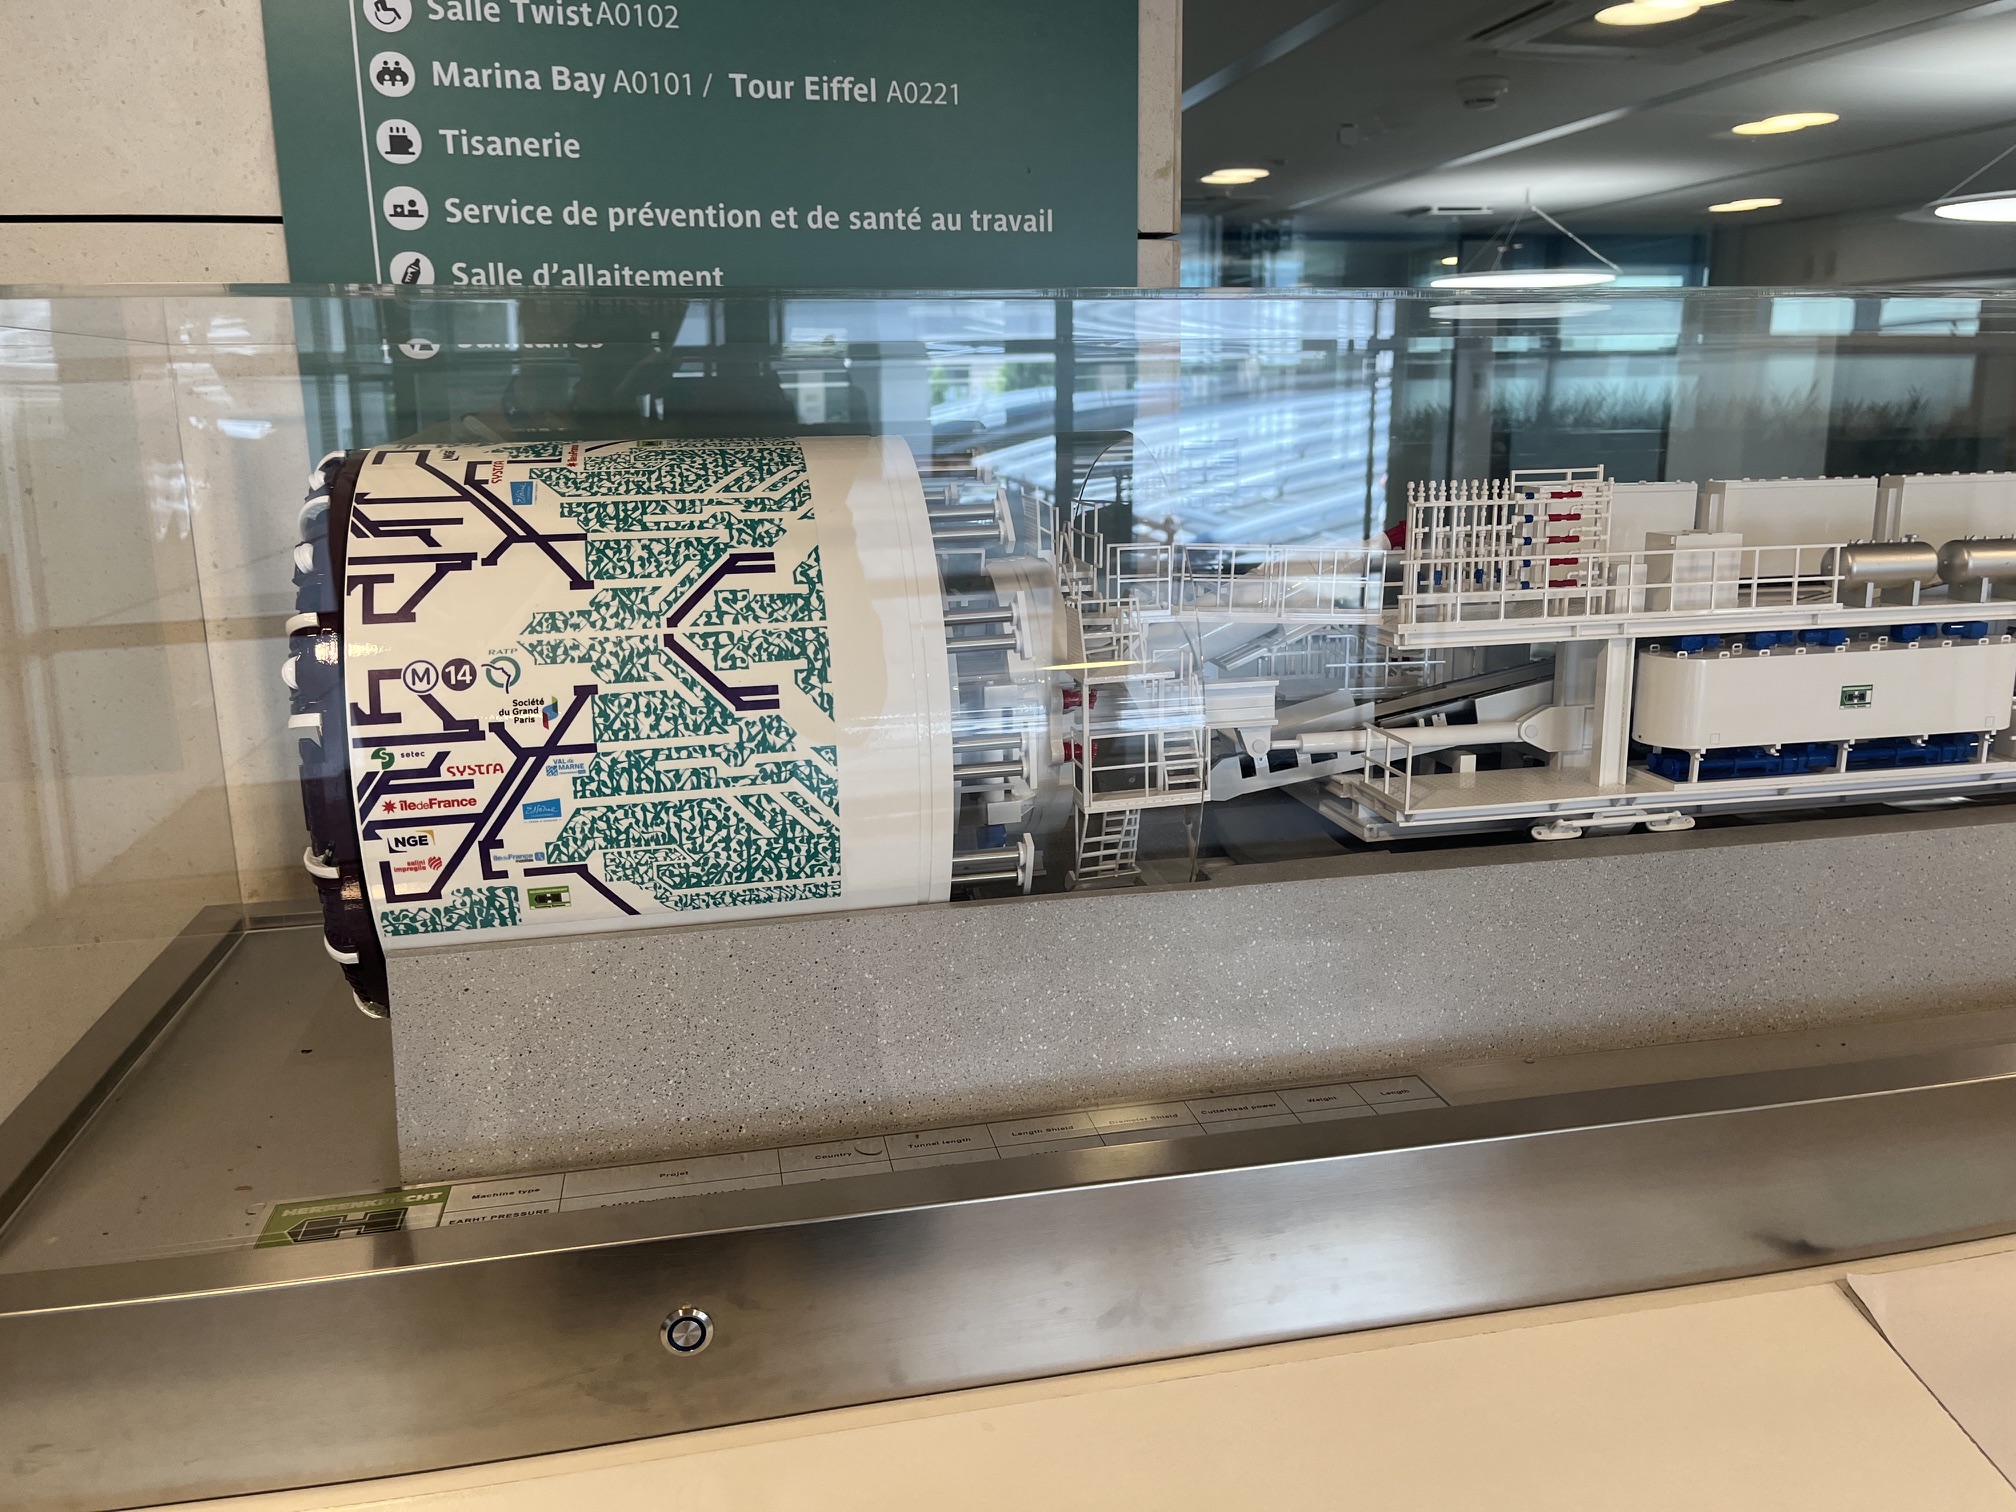
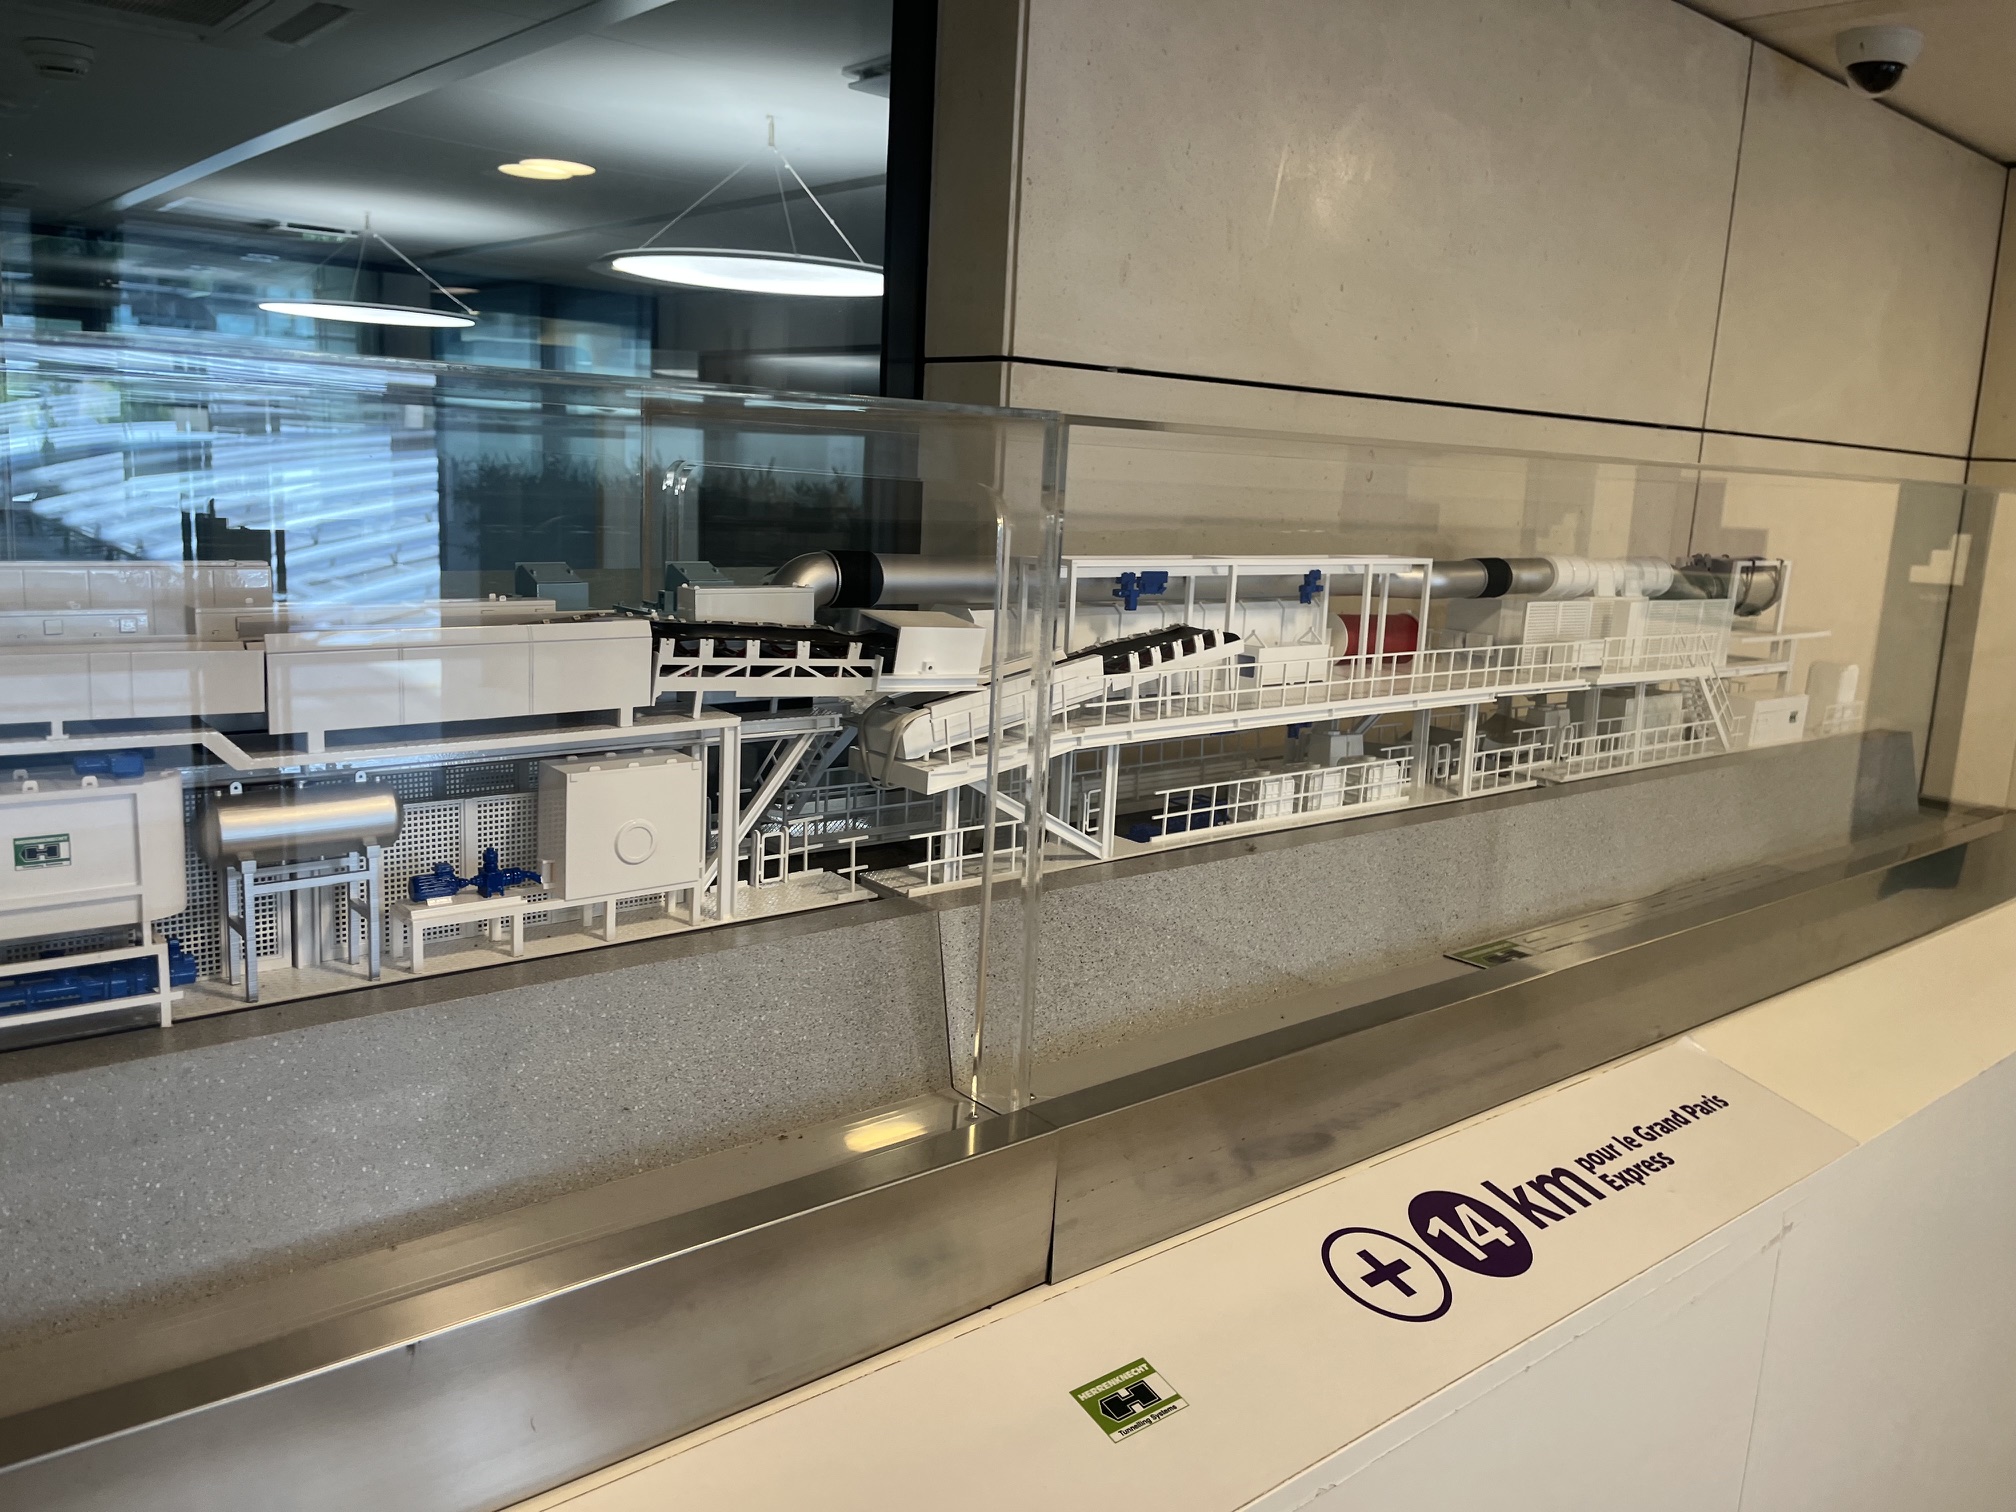
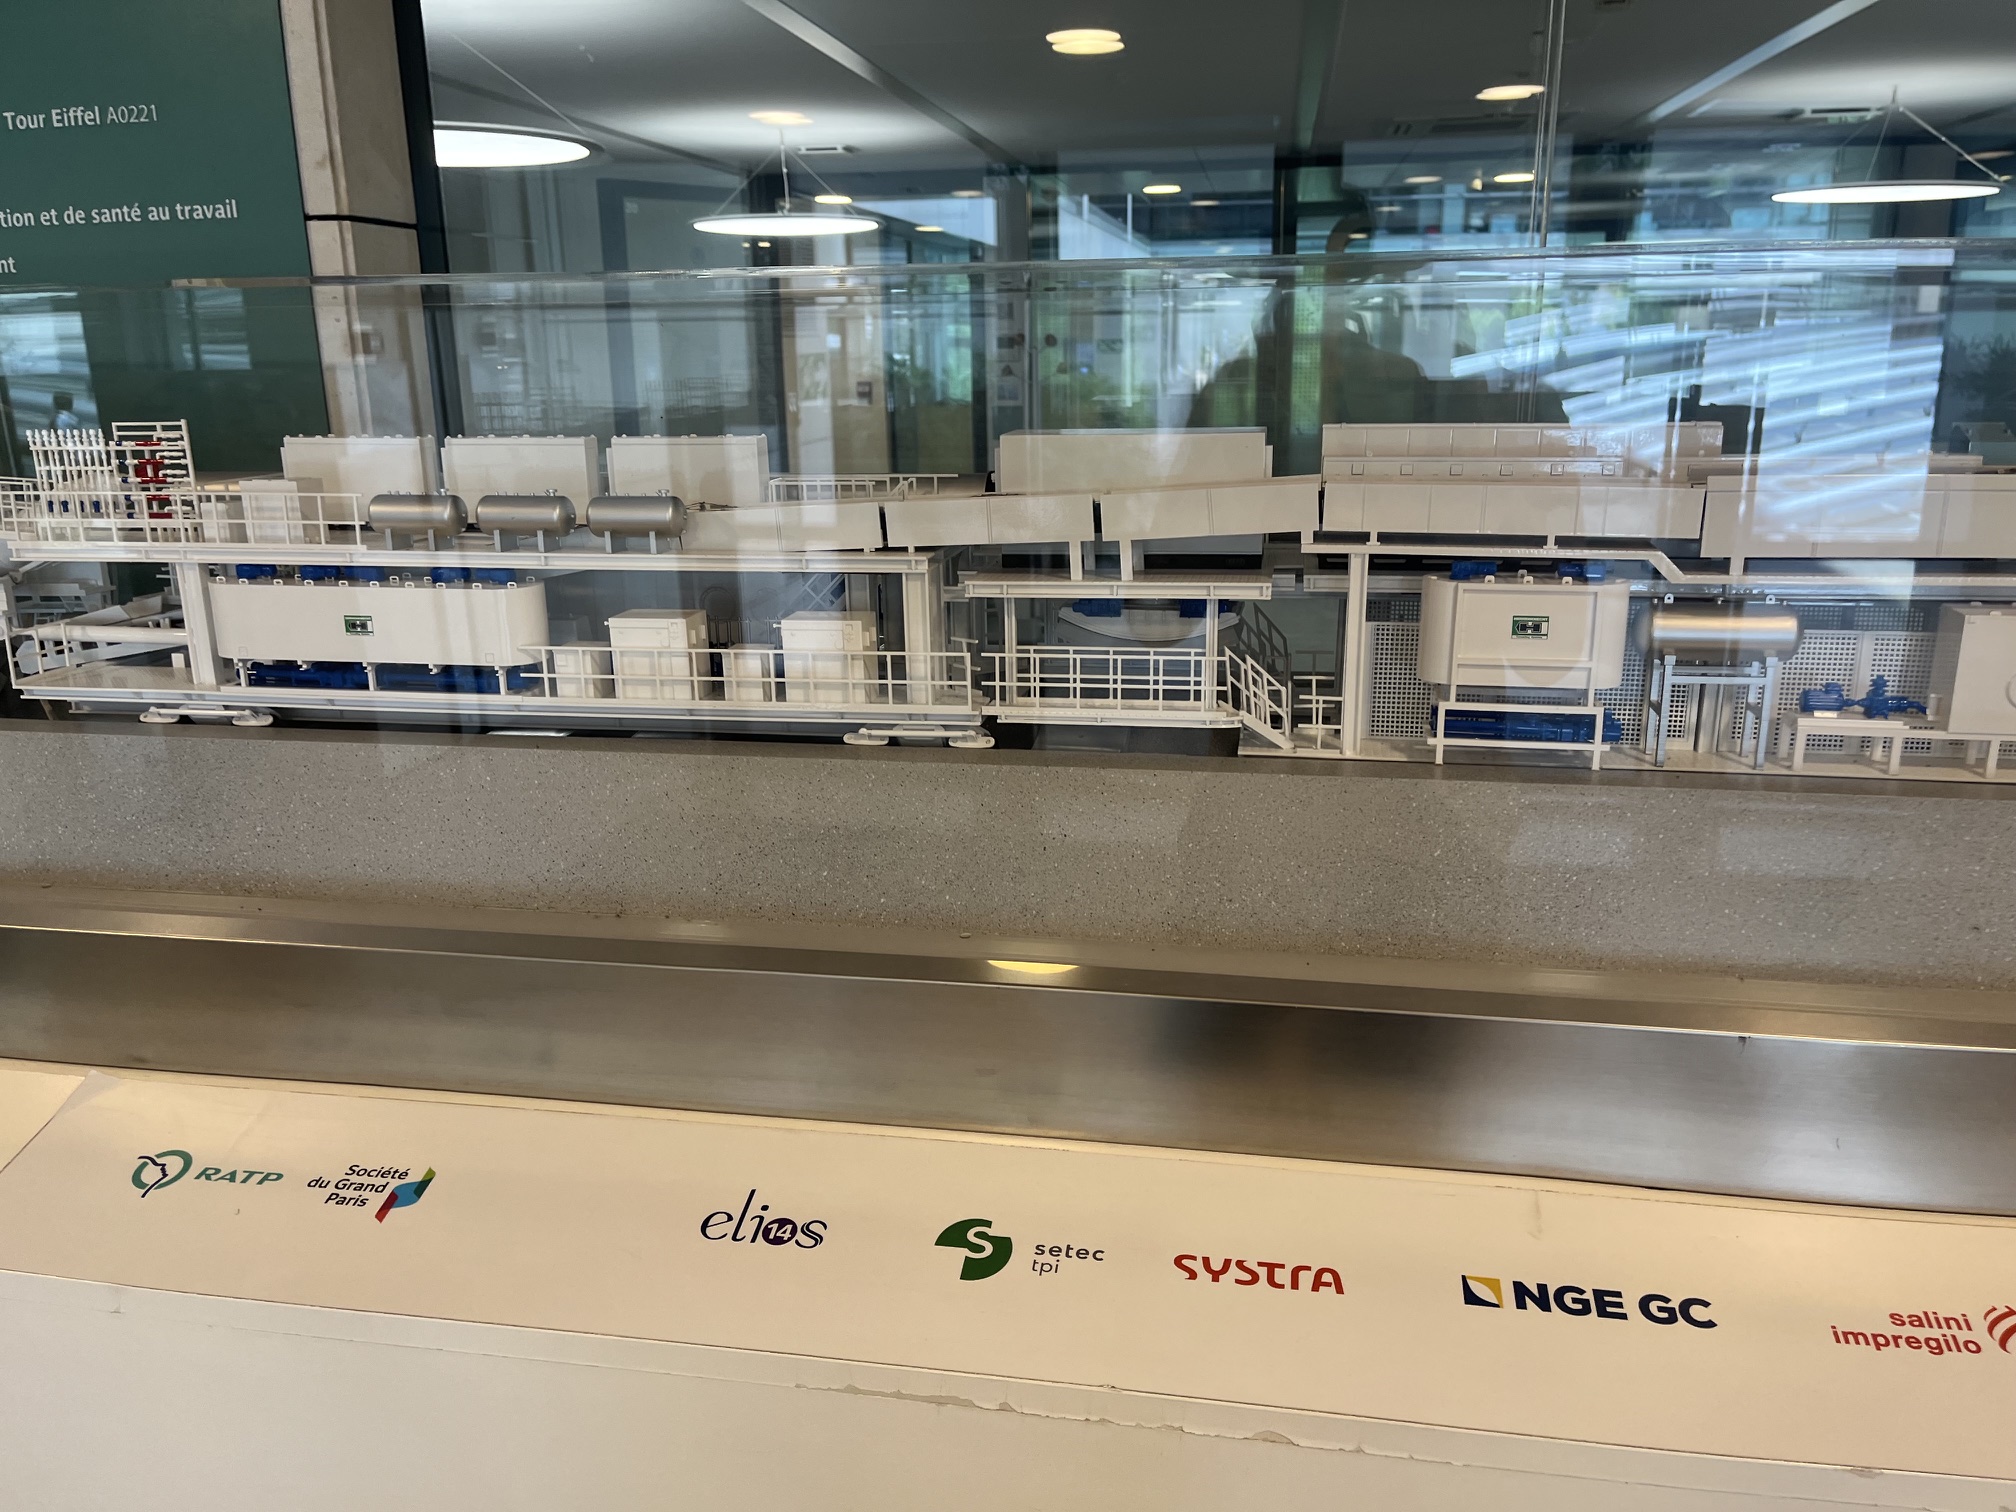
Maquette du tunnelier de la ligne 14 (à taille réelle, il fait une centaine de mètres de long)
A cause des bugs sur le SharePoint du pôle réglementation, j'ai reçu l'ordre de ne plus y toucher jsuqu'à nouvel ordre. J'ai donc commencé à travailler sur la tâche d'Hakima : faire du tri dans les Archives du pôle formation. Plus précisément, je dois supprimer tous les fichiers qui sont là "depuis trop longtemps" : Hakima m'a imprimé un tableau qui, pour chaque type de document (pièce d'identité, convocation, attestation de stage...) indique le délai à partir duquel le document doit être supprimé.
A première vue, cela ne semble pas trop difficile. Mais ces archives contiennent environ 6000 documents, et il serait très très fastidieux de tous les vérifier à la main (en supposant 10 secondes par document - car certains ont des noms qui ne donnent pas d'informations sur leur nature - cela me prendrait 60000 secondes, ou un peu moins de 7 heures... sans compter le temps de vérification et de navigation entre les dossiers).
Donc, comme pour les archives du pôle réglementation, j'ai commencé à écrire un script qui classe automatiquement les fichiers identifiables par leur nom. La V1 de ce script a déjà permis de classer environ 85% des documents (ce qui est vraiment pas mal) en les renommant selon la logique suivante : les documents non identifiables via leur nom ont le préfixe xIGNOREDx (de base, les x...x étaient des [...], mais j'ai eu des problèmes de caractères pas compatibles à cause des []), ceux identifiables et périmés ont le préfixe xEXPIREDx, et ceux identifiables non périmés commencent par xTREATEDx.
Pour cette journée, je n'ai pas encore supprimé de document, je les ai simplement renommés (au cas où j'aurais fait une erreur dans les dates de péremption ou dans les conditions de détection).
Même chose que la veille : j'ai continué à améliorer (et à corriger) le script de classement automatique des archives du pôle formation (comme je l'avais anticipé, il y avait des bugs dans la V1). J'ai donc abouti à une V2 du script qui classe environ 92% des documents (toujours sans les supprimer), ce qui fait que je n'avais plus que ~500 documents (sur 6000) à classer.
La structure du programme est assez moche (d'un point de vue code) : il s'agit d'une succession de if/else structurés comme suit :
if(nom_du_fichier contient "string_1" et "string_2" et ... et "string_N") {
    # fichier de type "TYPE_k"
    date_max = constante_qui_dépend_du_type_de_fichier
}
C'est ce que j'ai fait pendant l'après-midi : tous les documents commencant par xIGNOREDx ont été manuellement classés selon leur type/date de péremption.
En parallèle, des collègues (en télétravail) nous ont appelé car l'une des collègues a eu un problème de synchronisation avec SharePoint (here we go again) : en outre, elle a perdu sa synchronisation avec les Archives (du pôle réglementation) et des dossiers En Préparation (ce qui est un peu plus grave... car ce dossier contient tous les documents qui sont en cours d'édition avant publication/parution).
Dernier jour de la semaine. J'ai commencé la journée par vérifier tous les documents des archives du pôle formation commencant par xEXPIREDx (pour m'assurer de ne pas supprimer de document non périmé). En faisant ce double-check, une petite quinzaine de documents se sont avérés être mal classés.
Une fois cette vérification effectuée, j'ai enfin supprimé tous les fichiers expirés, puis j'ai rapidement fait un autre script pour renommer (aka supprimer les préfixes) les fichiers encore présents.
Avant de partie en weekend, j'ai aidé Mélissa par rapport à une interrogation sur Word : en faisant du publipostage (pour générer automatiquement des diplômes à partir d'un fichier Excel) (je ne savais pas ce que c'était au moment où elle m'a contacté), les dates apparaissent en anglais (mois/jour/année). J'ai donc fait quelques recherches pour comprendre le fonctionnement, puis j'ai réussi à trouver une solution pour mettre les dates en convention française (convertir le fichier Excel dans une verison plus ancienne pour pouvoir l'importer en convention DDR).
Déja 80% du stage écoulé... et plus qu'une semaine à vous raconter. A la semaine prochaine !